token.ee — kolmekeelne väljaanne, mis seletab AI-d lihtsate sõnadega
Kolmekeelne väljaanne, mis seletab AI-d lihtsate sõnadega — viiesammuline tee algajale, lause haaval kirjutatud sõnastik, reaalajas töötav tokeniseerija ning artiklid eesti, inglise ja vene keeles, ehitatud selleks, et otsing need üles leiaks ja AI-assistendid neid tsiteeriksid.
- Klient
- token.ee
- Valdkond
- Digikirjastamine
- Ajakava
- 1 nädal
- Aasta
- 2026
- Tehnoloogia
- PostgreSQLTypeScriptNext.jsnext-intlWebGPU / vGPUgpt-tokenizerCloudflare R2Tailwind CSS
- Veebileht
- www.token.ee
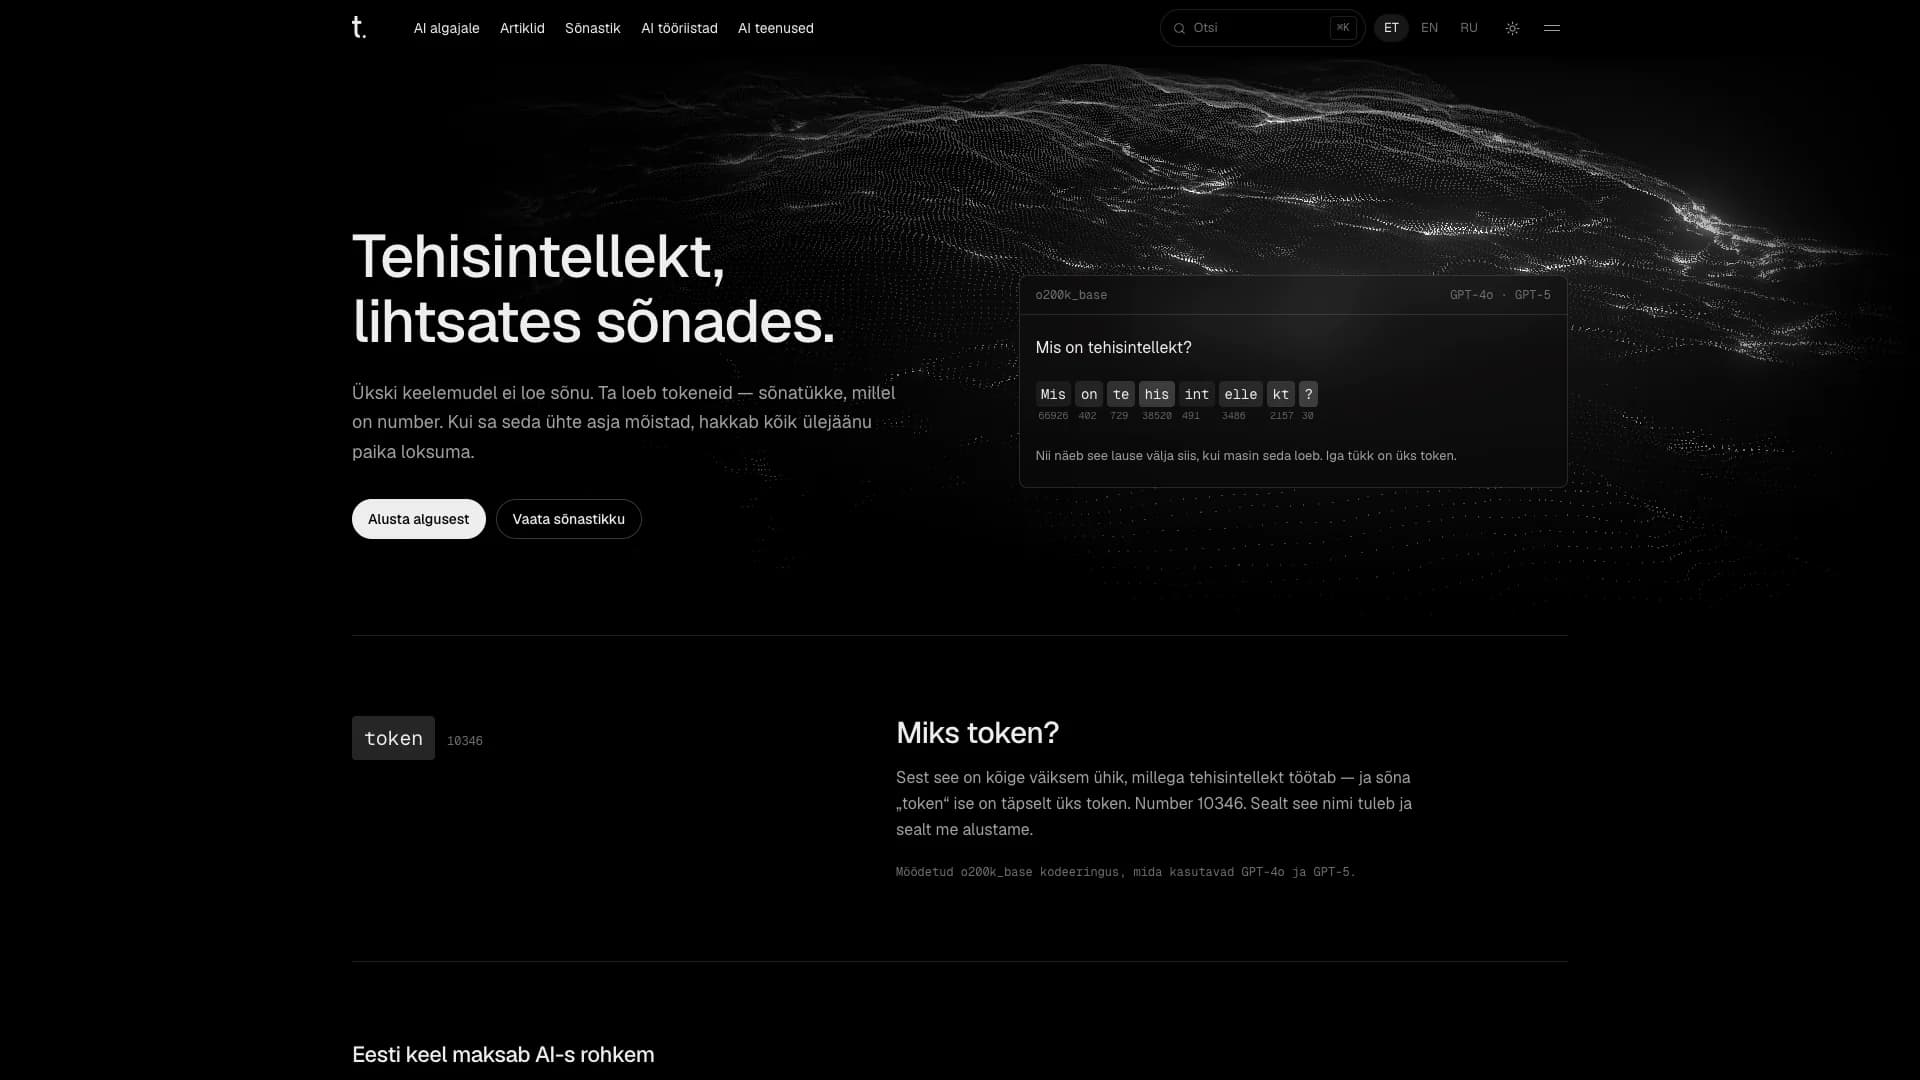
token.ee seletab tehisintellekti lihtsate sõnadega inimestele, kes ei ole tehnilised ega peaks AI kasutamiseks tehniliseks muutuma. Väljaanne ilmub eesti, inglise ja vene keeles ning alustab sealt, kust alustab masin. Keelemudel ei loe sõnu, ta loeb tokeneid — tekstitükke, millel on küljes number — ja kui lugeja selle ühe idee kätte saab, hakkab ülejäänu paika loksuma: miks vastus võib kõlada kindlalt ja olla ikkagi vale, miks pikk vestlus unustab oma alguse, miks küsimise viis muudab seda, mida vastuseks saad. Leht kannab selle idee nime ja nimi on ühtlasi esimene õppetund: kodeeringus, mida kasutavad GPT-4o ja GPT-5, on sõna token ise täpselt üks token. Ehitasime väljaande algusest lõpuni — tee algajale, sõnastiku, interaktiivse tokeniseerija, kolm omakeelset väljaannet ning otsingu, avaldamise ja leitavuse masinavärgi nende all.
Võimalus
Peaaegu igaüks on tänaseks mõne küsimuse ChatGPT-sse kirjutanud. Palju vähem inimesi teab, mis siis edasi juhtub, ja just sellest vahest tuleb enamik pettumusi AI-ga — mitte halvast tööriistast, vaid valedest ootustest. Kes usub, et mudel otsib fakte järele, usaldab väljamõeldud viidet. Kes usub, et mudel mäletab kõike, on üllatunud, kui pikk vestlus jutu järje kaotab. Selgitused, mis seda parandada saaksid, on enamasti kirjutatud inseneridele, kirjutatud millegi müümiseks või kirjutatud inglise keeles.
See viimane vahe loeb Eestis, kus loetakse kolmes keeles: eesti keeles tööl ja avalikus elus, vene keeles, mis on emakeel suurele osale elanikkonnast, ja inglise keeles, milles saabuvad kõik mujalt tulijad. Lugejal, kes tahab aru saada, mis on kontekstiaken, ja seda keeles, milles ta mõtleb, on olnud väga vähe lugeda — ja sama vähe on olnud lugeda AI-assistendil, keda ta üha sagedamini selle asemel küsib ja kes saab korrata ainult seda, mida keegi on juba avaldanud.
Lähteülesanne oli seletada AI-d nii, nagu seletaksid seda sõbrale, kes on tark, aga pole teemast lugenud: ilma žargoonita, ilma hüpeta, ilma ringmääratlusteta ning kolme omakeelse väljaandena, mitte ühe keelevahetajaga lehena. Ja kuna leht õpetab lugejale, miks AI asju välja mõtleb, ei saanud ta endale lubada ise midagi välja mõelda.
Mida me ehitasime
Sissepääs täiesti algajale
Ükski koht lehel ei eelda, et lugeja sõnavara juba tunneb. Navigatsiooni esimene link ja avalehe esimene nupp viivad lehele Tehisintellekt algajale, mis algab lubadusega, mida ülejäänud leht peab pidama: sa ei pea olema tehniline inimene, pead teadma viit asja ja ülejäänu on harjutamine. Viis sammu käivad kindlas järjekorras ja võtavad umbes tunni: saa aru, et keelemudel ennustab järgmist tekstitükki, mitte ei tea midagi; õpi ära sõna token; küsi korralikult; kontrolli alati üle; otsusta, mida sisestad. Igaüks mahub kahte-kolme lausesse ja alles siis juhatab leht lugeja edasi sõnastiku ja tokeniseerija juurde.
Üksteist artiklit võtavad ette küsimused, mida inimesed päriselt küsivad: mis on token, miks AI valetab, mis on kontekstiaken ja miks AI sind unustab, kuidas kirjutada head promptit, kuidas masin mürast pildi teeb. Igal artiklil on lugemisaeg ja raskusaste kohe alguses näha, lisaks sisukord ja pealkirjade ankrulingid, millega saab jagamiseks lingi kopeerida. Üheksa teemalehte koondavad artiklid selle järgi, milleks lugeja tuli, ja kaks võrdlust vastavad valikutele, mille ees lugejad päriselt seisavad: ChatGPT, Claude või Gemini ning kas AI eest tasub maksta. Isegi kaanepildid järgivad reeglit. Need näitavad asja otse, mitte metafoorina: ei mingeid helendavaid vooluringe ega hologramme. Algaja ei peaks pilti lahti muukima, enne kui jõuab selle all olevat pealkirja lugeda.
Sõnastik, kirjutatud lause haaval
Sõnastik on lehe selgroog. Selles on kakskümmend seitse mõistet alates tokenist ja promptist kuni RAG-i, MCP ja AI Actini ning need on jagatud kuude rühma: põhimõisted; keelemudelid; tööriistad; pildid, heli ja video; äri ja õigus; turvalisus. Iga mõiste algab ühe lausega, mille lugeja saaks kellelegi edasi rääkida, ja järgib siis alati samu kolme sammu: Lihtsalt öeldes, Näide ja Miks see sinu jaoks oluline on. Lugeja, kes on ühest mõistest aru saanud, oskab järgmist juba lugeda. Seda kuju ei loodeta, see jõustatakse. Sisukontroll märgib ära iga mõiste, mille pealkirjad teistest lahku triivivad, ja just nii jäi vahele venekeelne mõiste pealkirjaga Простыми словами, kuigi ülejäänud kakskümmend kuus kasutasid Проще говоря. Mõlemad on korrektne vene keel, aga konventsioon on ainult üks — ja just see teeb sõnastiku silmaga kiiresti läbitavaks.
Ükski lugeja ei tohiks ühe sõna taha kinni jääda. Sõnastikumõiste esimene mainimine igas artiklis muutub renderdamisel lingiks selle definitsioonile, pikemad mõisted enne lühemaid, nii et suur keelemudel saab vaste enne kui keelemudel. Sobitamisel kasutatakse Unicode'i arvestavaid sõnapiire, sest JavaScripti \b tunneb ainult ASCII-d ja leiaks rõõmsalt vaste ka kirillitsas või täpitähtedega sõna seest, ning iga mõiste loetleb oma käändevormid, sest eesti keeles jääb nimisõna harva sellesse käändesse, milles ta sõnastikus kirjas on. Ühtegi neist linkidest ei hoia keegi käsitsi korras.
Näitame, kuidas masin loeb
Tokeneid on lihtsam näidata kui kirjeldada, nii et leht näitab neid. Avalehe kangelaspilt paneb poolläbipaistvale kaardile ühe küsimuse — Mis on tehisintellekt? — kõigepealt nii, nagu inimene seda loeb, ja siis nii, nagu mudel: kaheksa tükki, igaühel oma tokeni number. Inglise keeles on sama küsimus viis tükki — juba see vahe on õppetund. Need numbrid ja iga sõnastikumõiste tokenite arv tulevad päris o200k_base tokeniseerijast, mitte kellegi käsitsi sisestatud arvust.
Tokeniseerija leht teeb ideest mänguasja. Kirjuta ükskõik mida, ükskõik millises kolmest keelest, ja vaata, kuidas tekst juba kirjutamise ajal värvilisteks tokeniteks jaguneb, koos tokenite, tähemärkide ja sõnade arvuga ning lülitiga, mis näitab iga tokeni numbrit. Kõik käib lugeja brauseris — teksti ei saadeta kuhugi — ja umbes 3,6 MB suurune sõnavara laaditakse alles vajaduse korral ning ainult sellel lehel, nii et ülejäänud lehtedel ei maksa see midagi.
Kolm väljaannet, mitte kolm tõlget
Eesti keel on vaikimisi keel ja serveeritakse eesliiteta paljalt domeenilt; inglise ja vene keel elavad aadressidel /en ja /ru ning igal marsruudil on igas keeles oma slug — /artiklid/mis-on-token, /en/articles/what-is-a-token, /ru/statji/chto-takoe-token. Eestikeelsetest slugidest on täpitähed välja jäetud ja venekeelsed on transliteeritud, sest just nii inimesed kirjutavad, ning vahevara hoolitseb selle eest, et next-intl ei pakuks hreflang-siltides ühe artikli slugi kõigi kolme keele jaoks.
Väljaanded on kirjutatud oma lugejatele, mitte ümber konverteeritud. Artikkel sellest, et eesti keeles on AI jaoks kaks sõna, tehisintellekt ja tehisaru, küsib eestikeelses väljaandes, miks eestlased selle üle vaidlevad. Ingliskeelsele lugejale on see väike uurimus sellest, kuidas keel uue mõiste omaks võtab, venekeelne väljaanne lisab aga, mida see tähendab Eestis elavale venekeelsele inimesele: sõnavalik otsustab, mida ta eestikeelsetest allikatest üles leiab. Kolm tähestikku kõrvuti tekitavad ka vigu, mida ükski korrektor ei näe. Kirillitsa о eesti sõna sees on ladina omaga pikslitäpselt sama ja lõhub vaikselt selle sõna otsingu. Seepärast käib iga tekst läbi kirjasüsteemide kontrolli, mis püüdis esmaehituse ajal kinni neli sellist libastumist, nende seas ühe eksinud CJK-märgi venekeelses väljaandes.
Otsing, mis saab aru, kuidas inimesed kirjutavad
Lugejad ei kirjuta nii, nagu indeks ootab. Nad jätavad täpitähed ära, otsivad poolt liitsõnast ja kasutavad hüüdnimesid. Otsing sai alguse staatilisest indeksist, mille brauser otsingukasti esimesel avamisel alla laadis ja mis nägi pealkirju ja lühikirjeldusi, aga mitte artiklite sisu — seitse kaheksandikku lehe tekstist ei olnud leitav. Nii kolis sobitamine sinna, kus tekst elab, PostgreSQL-i, ja brauser esitab nüüd küsimuse, selle asemel et korpust alla laadida.
Esimene andmebaasiversioon oli tagasiminek ja selle püüdis kinni testimine, mitte arutlemine. Postgresi eesliitesobitus leiab vasteid ainult sõna algusest, eesti keel aga liimib sõnad kokku, nii et otsing ettevottele ei leidnud artiklit AI väikeettevõttele. Parandus filtreerib alamstringi järgi iga otsitava välja täpitähtedeta koopial, mida toetab trigrammindeks, ja järjestab tulemused kaalutud tekstivektori järgi: pealkiri kõige kaalukam, sisu kõige kergem. Täpitähed taandatakse, nii et sonastik leiab sõna sõnastik, ja tekstikonfiguratsioon on simple, sest Postgresiga ei tule kaasa eesti keele sõnastikku ning eesti keele tüvestamine inglise sõnastikuga on hullem kui üldse mitte tüvestada. Teemalehed, teenused ja tööriistade kataloog ilmuvad samas tulemuste loendis, nii et lugeja, kes on kuulnud ainult hüüdnime nano banana, jõuab ikkagi Geminini — ja sõna kontekstiaken sisestamine maksab kolmteist klahvivajutust ja ainult ühe päringu.
Avaldamine ilma juurutuseta
Artiklid elavad PostgreSQL-is. Need on majutatud Supabase'is, aga kirjutatud tavalise Postgresi peale: tavaline SQL tavalise draiveri kaudu, ilma teenusepakkuja klienditeegita. Nii on teenusepakkuja ühendusstring, mitte arhitektuur. Sisukiht oli algusest peale asünkroonne, isegi siis, kui artiklid olid veel markdown-failid, ja seetõttu oli andmebaasi kolimine üherealine muudatus; enne failide kõrvaldamist ehitati leht mõlemat pidi ja väljundit võrreldi baidi täpsusega. Avaldamine on nüüd üks andmebaasi kirjutatud rida. Andmebaasi päästik kutsub iga muudatuse peale lehe revalideerimise otspunkti, Next.js 16 Cache Components genereerib uuesti muutunud lehe ja loendid, kus see kirjas on, kõik muu jääb aga vahemällu, ning saidikaart ja mõlemad llms-failid värskenduvad minuti jooksul iseenesest. Uus selgitus on leitav peaaegu kohe, kui see olemas on.
Ookean sõnade taga
Kangelaspilt asub elava ookeani peal: FFT-lainesimulatsioon, mis arvutatakse GPU-l WGSL-is ja joonistatakse helendavate osakeste väljana ning renderdatakse vGPU-ga, Vercel Labsi WebGPU-teegiga. See sai alguse three.js stseenina, mis kaotas navigeerimisel ikka ja jälle oma WebGL-konteksti — kahe graafikakiibiga sülearvutis on juba kiibivahetus ise konteksti kadu — ja pärast nelja sihitud parandust kolisime selle WebGPU peale, selgesõnalise loomise ja vabastamise elutsükliga, mis valvab iga asünkroonset piiri. Osakesed segunevad aditiivselt, nii et nad saavad ainult helendada, ja seepärast jääb kangelaspilt nii heledas kui tumedas teemas mustaks. Varulahendust meelega ei ole: all on alati staatiline CSS-taust, WebGPU-ta brauser näeb lihtsalt seda ja kangelaspildi iga sõna on igal juhul serveris renderdatud. Muu kujundus hoiab end tagasi: must ja valge, juuksepeened jooned, tekstikiri Geist ja logo, mis on väike t ja punkt.
Aus seal, kus otsus sünnib
Leht, mis õpetab inimesi AI vastuseid kontrollima, peab ise olema kontrollitav. Analüütika laaditakse ainult pärast selgesõnalist nõusolekut; keeldumise või vastamata jätmise korral ei laadita üldse midagi. AI tööriistade kataloog — kolmteist tööriista seitsmes kategoorias, rühmitatud selle järgi, mida lugeja teha tahab, mitte tootja järgi — ei näita hindu, sest aegunud hind jätab hoolimatu mulje. Selle kaks soovituslinki on avalikult märgitud just seal, kus lugeja otsustab: lingil on rel="sponsored", kõrval nähtav märgis ja lehe ülaosas püsiv märkus, ning kõiki kolme juhib üks lipp andmetes. Reegel kirjutati koodi enne, kui esimene tasuline link üldse olemas oli: nimekirja ja järjekorra otsustab kvaliteet, vahendustasu ei otsusta midagi. Brändimärgid pärinevad avatud litsentsiga allikatest või toodete endi graafikast, mitte kunagi käsitsi joonistatud lähendustest, ning neid hoitakse oma serveris, mitte ei laadita otse tootja juurest, nii et ükski tootja ei näe külastajat enne nõusolekut. Kontaktivorm kontrollib Cloudflare Turnstile'i tokenit serveri poolel, saadab päringud ERPFlow.ai müügivihjete API-sse ja kui see ühendus peaks kunagi valesti seadistatud olema, annab ta vea valjult, mitte vaikides.
Kirjutatud tsiteerimiseks
Inimesed küsivad üha sagedamini assistendilt, enne kui otsingumootori avavad, ja väljaandele, mille eesmärk on AI-d seletada, on kogu mõte olla see allikas, mida assistent tsiteerib. Sõnastiku ühelauselised definitsioonid on täpselt selline tekst, mida assistent saab tervikuna üle võtta, ja need on märgendatud selleks, mis nad on: DefinedTermSet, mille iga mõisteleht on DefinedTerm, mis viitab tagasi kogumile. Avalehe lühikesed vastused on FAQPage, artiklite autor on väljaande Organization, mitte isiklik autorinimi, ja teenuste kataloog on OfferCatalog, mis ei väljasta hinda, sest väljamõeldud arv oleks hullem kui arvu puudumine. llms.txt kaardistab võtmelehed, teenused ja iga sõnastikumõiste; llms-full.txt kannab kõigi kolme väljaande täisteksti, umbes 22 600 sõna ühe päringuga; ning robots.txt nimetab otsesõnu üheksateist roomajat, alates GPTBotist ja ClaudeBotist kuni PerplexityBoti ja YandexBotini.
Tulemus
token.ee valmis nädalaga: 195 URL-i — 65 lehte nii eesti, inglise kui ka vene keeles. Nende seas on viiesammuline tee algajale, üksteist artiklit, kakskümmend seitse sõnastikumõistet, kaks võrdlust, üheksa teemalehte, reaalajas töötav tokeniseerija ja kolmeteistkümne tööriistaga kataloog — kõik avaldatud PostgreSQL-ist, ilma juurutuseta. See on väike leht, millel on üks ülesanne. Lugeja, kes saabub teades ainult seda, et ChatGPT on olemas, võib lahkuda arusaamisega, miks see kõlab enesekindlalt ka siis, kui eksib, miks pikk vestlus unustab, kuidas ta algas, ja mida ei tohi kunagi tasuta kontosse kleepida — keeles, milles ta mõtleb, ja ilma et peaks enne tehniliseks inimeseks hakkama.